파이썬에서 같은 줄을 한 번만 남기고 처음 나온 순서를 유지하려면, 줄 목록을 만든 뒤 dict.fromkeys()로 중복을 정리하세요. 아래 다섯 줄 예제를 그대로 실행하면 사과·배·귤 세 줄이 남습니다. 공백이나 대소문자가 다르면 다른 줄로 취급하며, 이 코드는 파일을 수정하지 않고 결과를 출력합니다.
복사해 모은 짧은 항목 목록에 같은 이름이 여러 번 들어간 상황을 연습해 볼게요. 예제의 과일 목록은 가상 입력이고, 아래 결과는 2026년 9월 19일 macOS의 Python 3.14.4에서 직접 실행해 확인했습니다. Python 3.7 이상에서 쓸 수 있는 문법입니다.
먼저 다섯 줄을 세 줄로 바꿔 보세요
Python 3 실행 환경이 준비되어 있다면 다음 코드를 unique_lines.py라는 UTF-8 텍스트 파일에 저장하세요. 파일이 있는 폴더에서 python3 unique_lines.py로 실행합니다. 명령을 찾을 수 없다는 메시지가 나오면 설치나 실행 경로부터 확인해야 하므로 텍스트 변환 부분을 고칠 단계는 아닙니다.
text = """사과
배
사과
귤
배"""

lines = text.splitlines()
unique_lines = list(dict.fromkeys(lines))
result = "\n".join(unique_lines)

print(result)
print("줄 수:", len(lines), "->", len(unique_lines))
처음과 끝의 큰따옴표 세 개는 여러 줄을 하나의 문자열로 넣기 위한 표시입니다. 복사할 때 따옴표를 빠뜨리거나, 결과 예시까지 코드 파일에 이어 붙이지 않도록 해 주세요. 실행 결과는 다음과 같습니다.
사과
배
귤
줄 수: 5 -> 3
사과는 첫 번째 자리를 지키고, 배와 귤도 처음 등장한 순서대로 남습니다. 다섯 줄에서 중복된 두 줄을 제외했으므로 마지막 확인 숫자는 5 → 3입니다. 가나다순으로 정렬하는 코드는 아니에요.
줄 나누기, 중복 정리, 다시 잇기를 구분하세요
text.splitlines()는 줄 경계에서 문자열을 나눕니다. 이 예제의 lines는 ['사과', '배', '사과', '귤', '배']가 됩니다. Python의 문자열 문서에서 설명하듯 기본 호출은 줄 끝 문자를 항목에 넣지 않습니다.
dict.fromkeys(lines)는 각 줄을 사전의 키로 사용합니다. 같은 키가 또 나오더라도 키를 추가하지 않으므로 중복이 사라집니다. list(...)는 그 키들을 다시 목록으로 꺼냅니다. Python의 사전 설명에 있는 삽입 순서 규칙 덕분에 첫 등장 순서를 유지할 수 있어요. 순서가 중요한 이번 과업에서는 집합인 set의 출력 순서에 기대지 않습니다.
마지막 "\n".join(unique_lines)은 남은 항목 사이에 줄바꿈 하나씩을 넣어 문자열을 만듭니다. 숫자를 세는 len과 결과 문자열을 만드는 join의 역할은 다릅니다. 목록 길이가 낯설면 리스트의 개수와 합계를 구분하는 실습으로 이어갈 수 있습니다.
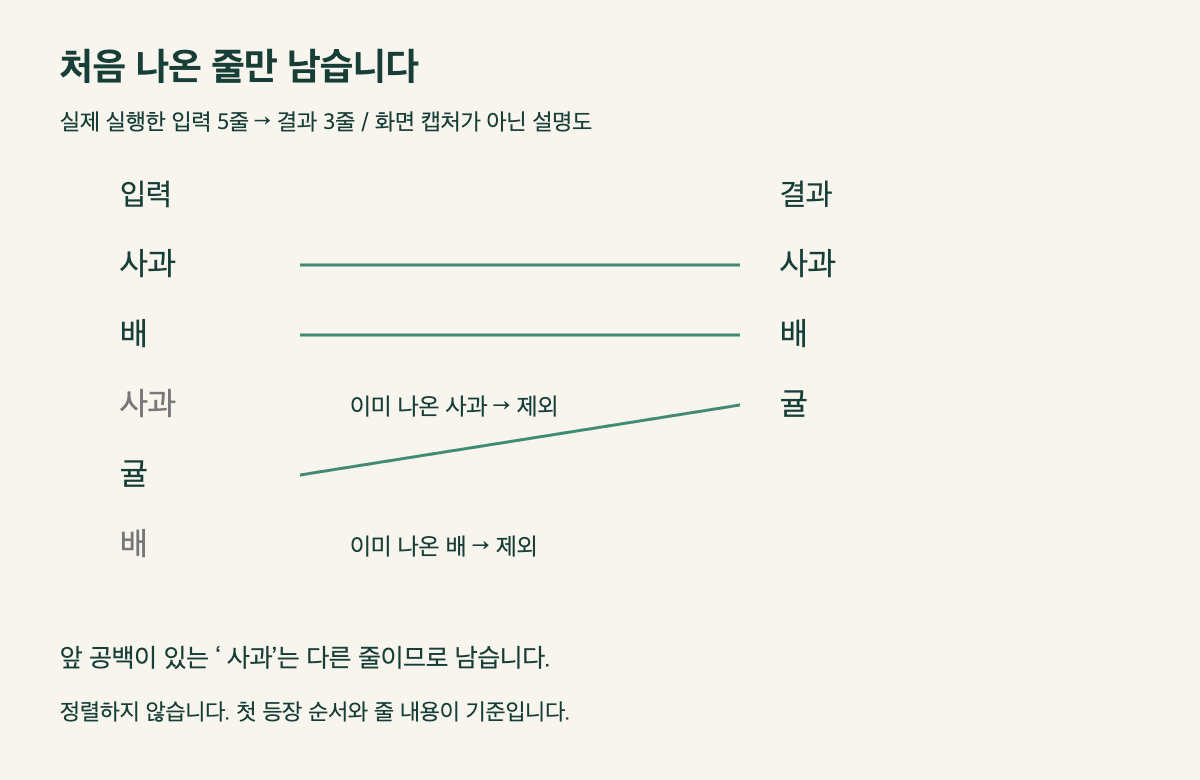
똑같아 보이는 줄이 남으면 공백을 확인하세요
예제의 입력만 다음처럼 바꿔 보세요. 두 번째 사과 앞에는 공백 한 칸이 있습니다.
text = "사과\n 사과\n사과"나머지 코드를 그대로 실행하면 3 → 2가 됩니다. 앞에 공백이 있는 ‘ 사과’는 ‘사과’와 다른 문자열이기 때문이에요. 끝에 print(repr(result))를 붙여 확인하면 다음처럼 보입니다.
'사과\n 사과'Python의 출력 설명에 나오는 repr는 문자열의 따옴표와 줄바꿈 표기를 보여주므로, 화면에서 지나치기 쉬운 차이를 확인하는 데 쓸 수 있습니다. 영문 Apple과 apple도 이번 코드에서는 서로 다른 줄입니다.
앞뒤 공백도 없애고 싶다는 이유로 바로 strip()을 추가하지는 마세요. 들여쓰기나 의도한 공백까지 달라질 수 있습니다. 먼저 ‘글자가 완전히 같은 줄만 합칠지, 공백 차이도 무시할지’를 정하고, 여기서는 완전히 같은 줄만 합치는 규칙을 유지하겠습니다.
빈 줄과 마지막 줄바꿈은 어떻게 되나요?
중간의 빈 줄도 빈 문자열 하나로 취급합니다. 빈 줄이 여러 번 있으면 첫 번째 빈 줄 하나만 남아요. "사과\n\n배\n\n사과"를 넣어 실행하면 결과의 항목은 ['사과', '', '배']이고, 줄 수는 5 → 3입니다. 화면에는 사과와 배 사이의 빈 줄이 하나 보입니다.
입력을 text = ""로 바꾸면 목록은 비고 줄 수는 0 → 0입니다. print(result)가 빈 줄을 출력한 뒤 줄 수를 보여주는 것은 오류가 아닙니다. 입력이 "사과\n배\n"처럼 줄바꿈으로 끝나도 마지막에 빈 항목을 하나 더 만들지는 않습니다.
이 코드가 보존하는 것은 남은 줄 내용과 첫 등장 순서입니다. 원래 줄바꿈 방식이나 파일 끝의 줄바꿈까지 보존하지는 않습니다. join은 항목 사이에만 \n을 넣고, print는 화면 출력 끝에 줄바꿈을 붙입니다. 그래서 코드 파일, 원문 서식, CSV처럼 줄 자체에 구조적 의미가 있는 자료 전체를 이 방식으로 정리하지는 마세요. 우선 짧은 단순 항목 목록에 적용하는 연습으로 범위를 잡으면 됩니다.
자기 목록을 넣기 전에 이 결과를 확인하세요
첫 예제에서 사과·배·귤과 5 → 3이 나오는지 확인한 뒤, 가상 입력에 과일 한 줄을 더 넣어 보세요. 이미 있는 사과를 추가하면 결과는 그대로이고 입력 줄 수만 하나 늘어야 합니다. 새로운 복숭아를 마지막에 추가하면 결과의 마지막에도 복숭아가 생겨야 합니다.
결과가 다르면 입력의 앞뒤 공백, 빈 줄, 따옴표와 줄바꿈 표기부터 확인하세요. 코드 실행 자체가 멈춘 경우에는 오류 메시지의 마지막 줄과 위치를 읽는 순서로 확인하면 됩니다. 작은 예제의 순서와 개수가 맞으면 원본을 따로 보관한 채 자기 목록의 복사본을 넣고, 남아야 할 항목이 빠지지 않았는지 대조해 마무리하세요.