링크에 어떤 검색 조건이 들어 있는지 보려면 URL 전체를 문자열로 자르지 말고 urlsplit()의 query를 parse_qs()로 읽으세요. 같은 이름의 조건이 두 번 나오면 값도 둘입니다. 이 연습에서는 직접 만든 두 URL만 분석하고 웹페이지에 접속하거나 링크를 열지 않습니다.
2026년 9월 27일 macOS의 Python 3.14.4에서 아래 코드를 그대로 실행했습니다. Python urllib.parse 공식 문서는 urlsplit()이 경로와 쿼리를 별도 값으로 돌려준다고 설명합니다. 같은 문서의 parse_qs() 설명에 따르면 한 이름의 값은 목록으로 반환됩니다.
연습 링크 두 개를 분석하세요
다음 코드를 check_query.py로 저장하고 python3 check_query.py를 실행하세요. Windows에서 그 명령이 없으면 설치된 Python의 py를 사용할 수 있습니다. example.com은 예시 문자열이며 요청을 보내지 않습니다. 실제 공유 링크에는 개인 식별자나 접근 토큰이 있을 수 있으므로, 먼저 이 예시로 동작을 확인하세요.
from urllib.parse import parse_qs, urlsplit

urls = (
    "https://example.com/search?q=python&q=blog&sort=new",
    "https://example.com/search?q=&sort=new",
)

for number, url in enumerate(urls, start=1):
    parts = urlsplit(url)
    values = parse_qs(parts.query, keep_blank_values=True)
    print(f"링크 {number}: 경로={parts.path}")
    print("검색어:", values.get("q", []))
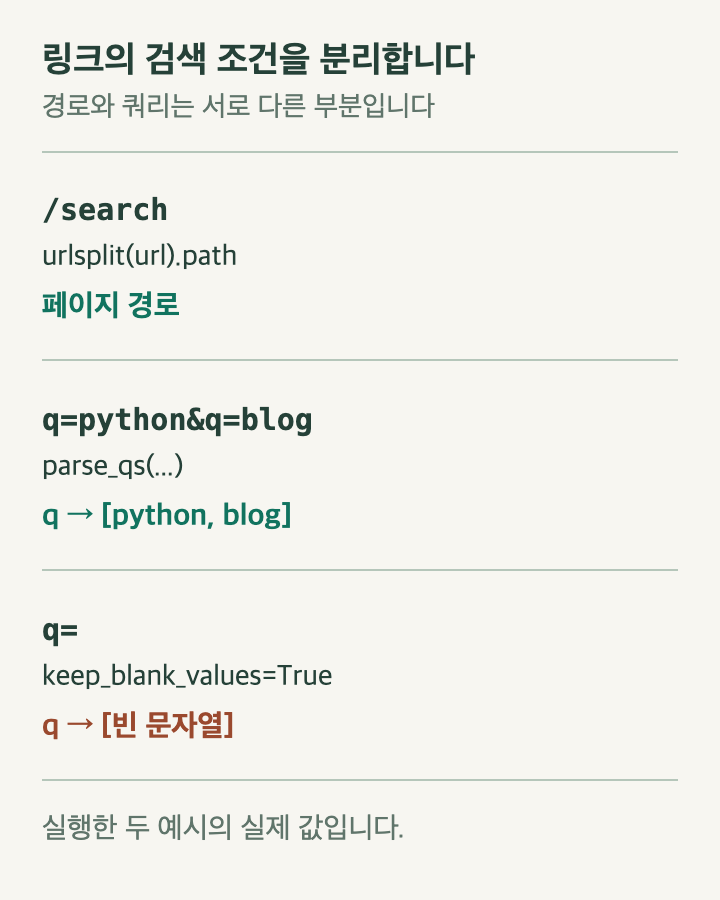
print("정렬:", values.get("sort", []))urlsplit()은 /search를 경로로, 물음표 뒤를 query로 나눕니다. parse_qs()는 그 쿼리를 이름별 목록으로 바꿉니다. 여기서는 keep_blank_values=True를 넣어 두 번째 링크의 빈 q=도 빠뜨리지 않았습니다. 이 옵션을 빼면 기본 동작에서는 빈 값을 무시합니다.
실제 출력에서 반복과 빈 값을 확인하세요
링크 1: 경로=/search
검색어: ['python', 'blog']
정렬: ['new']
링크 2: 경로=/search
검색어: ['']
정렬: ['new']
첫 링크의 q는 두 번 나와 ['python', 'blog']가 됩니다. 두 번째 링크의 q=는 값이 없지만, 빈 문자열이 들어 있는 목록 ['']로 남습니다. 원하는 이름이 없는 경우에는 코드의 values.get("이름", [])이 빈 목록을 돌려주므로, 빈 값 하나와 구분할 수 있습니다.
실제 링크에 적용할 때 구분하세요
결과가 예상과 다르면 먼저 물음표 뒤의 이름이 정확히 q인지, 같은 이름이 여러 번 나오는지, 값 없이 q=만 있는지 확인하세요. 실제 URL 전체를 공개 댓글이나 로그에 붙이지 마세요. 이 코드는 URL 문자열의 구조를 나눌 뿐 링크가 안전한지, 목적지가 신뢰할 만한지 검증하지 않습니다. 공식 문서도 urlsplit()을 URL 유효성 검사로 사용하지 말라고 경고합니다.
두 링크 모두 경로=/search가 나오고, 첫 검색어는 두 값, 둘째 검색어는 빈 문자열 한 값으로 나오면 실습이 끝난 것입니다. 링크 주소를 나중에 다시 찾는 문제가 있다면 변하지 않는 문서 주소를 저장하는 방법도 이어서 확인해 보세요.